审核中枢
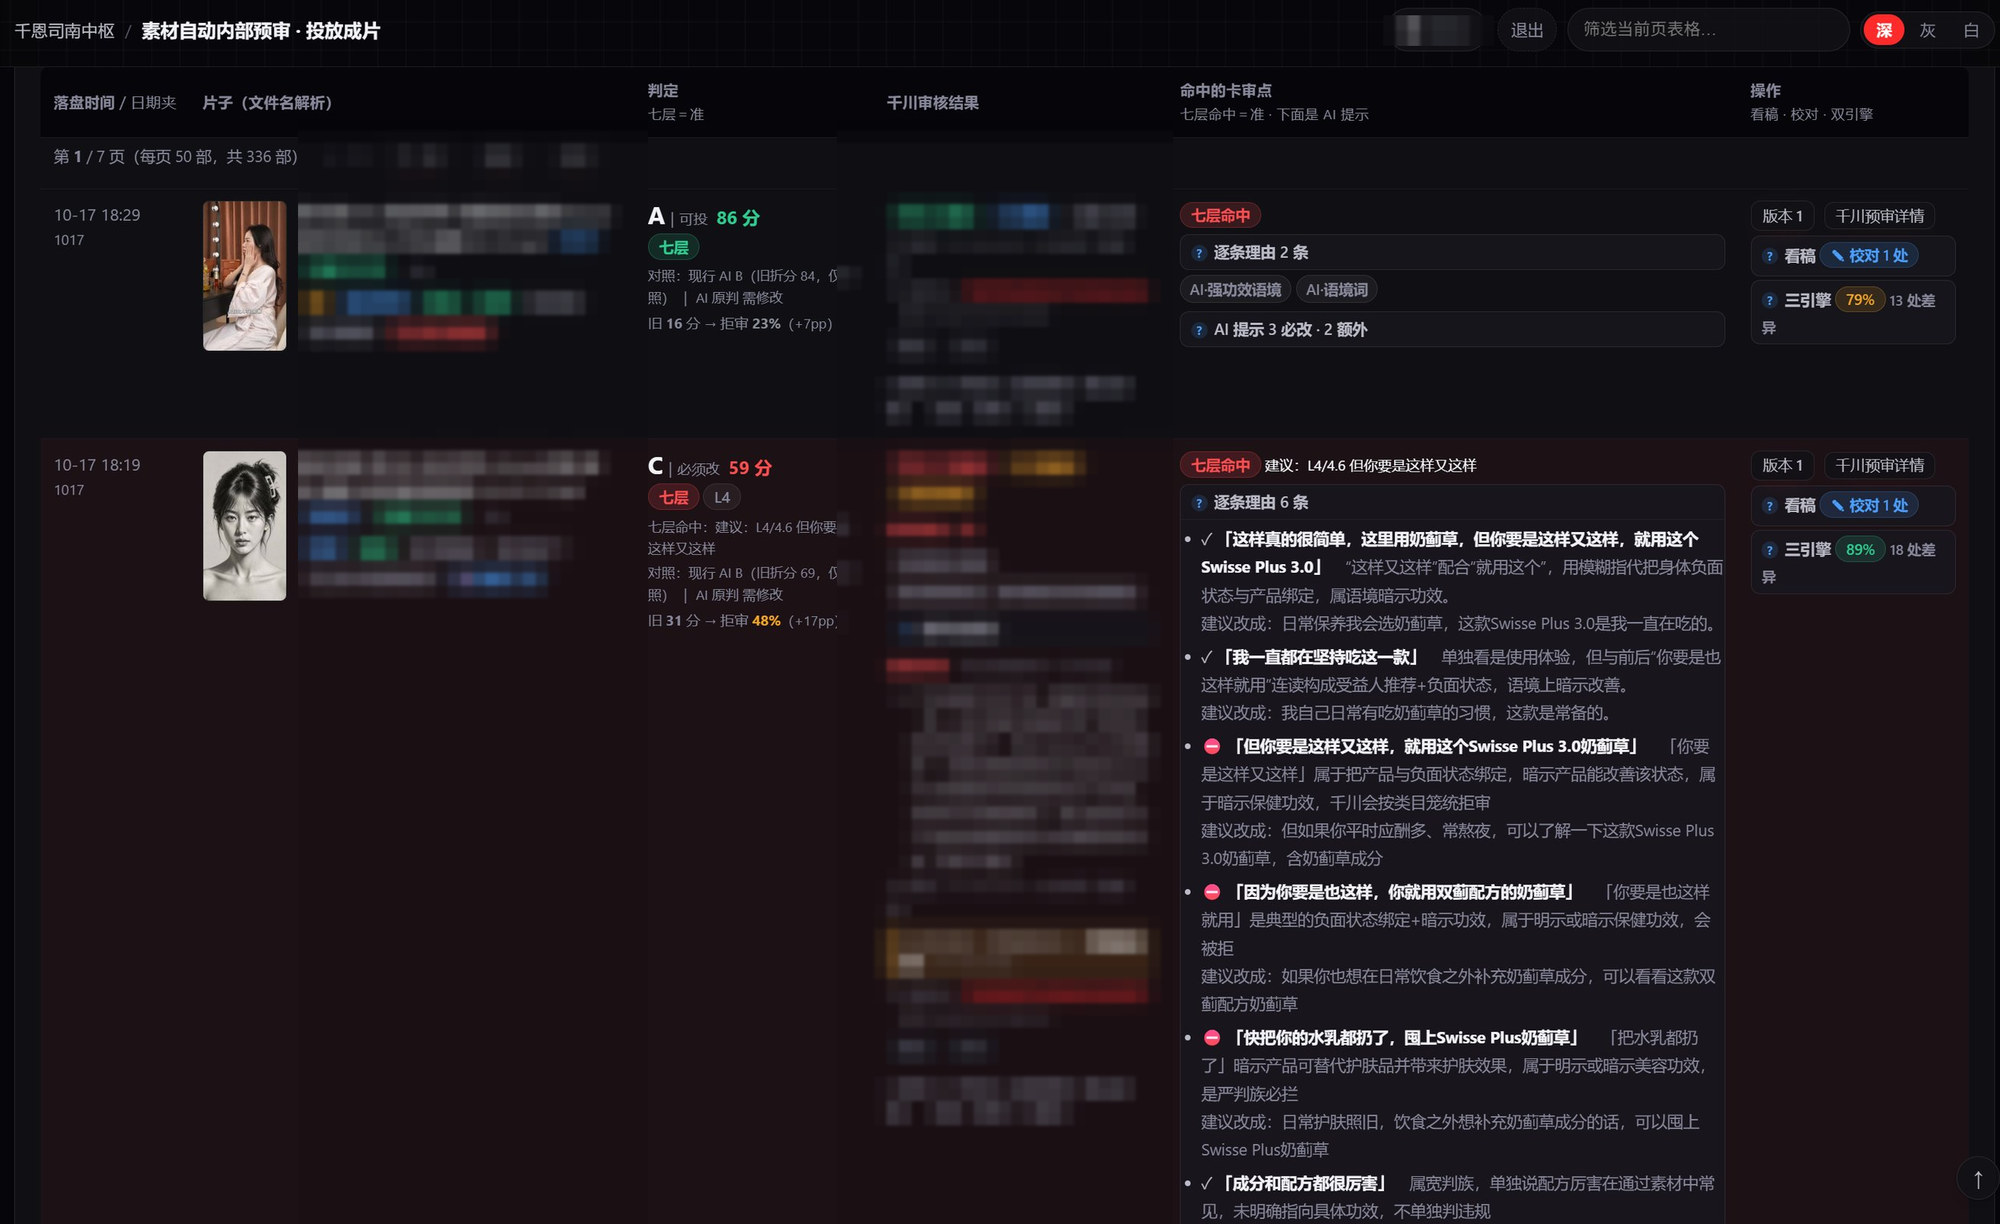
七层评分叠加平台判据复检,把"被拒了但不知道为什么"变成"哪一句、踩哪条、怎么改"。
/ 01 — Modules
素材进来、判断出去、数据回流。每个模块都能单独用,串起来才是一个闭环。
七层评分叠加平台判据复检,把"被拒了但不知道为什么"变成"哪一句、踩哪条、怎么改"。
内外部双轨:内部看投放结果,外部看结构框架。两个口径分开统计,结构层面合并对照。
分页浏览、封面小图按需缩略;音画关系与逐镜口播可查,未收录素材也能补齐判断。
每日自动拉取、字段对齐、异常黄条提示;静默失败当日可见,不用等到人发现。
图表选型锁定色板、整页报告装配、演示稿导出;字体内联,断网也能打开。
主播维度表现曲线与内容结构归因并排看,直接对应到"下一场改什么"。
/ 02 — Workflow
角色按动作分工,不按人分工。每段都有明确产出物,出了问题能定位到段。
素材入库、字段清洗、按身份建立映射,先把数据弄对。
口径先对齐,再算消耗、ROI、跑量占比与集中度。
图表、整页报告、演示稿、成片,按规格产出。
数字交叉核对、截图验稿、成片扫帧,过了才算完成。
/ 03 — Roles
一个角色一个职责。职责扩大就再开一个,不把一个角色用成万金油。
/ 04 — Guards & Self-Improvement
不靠自觉,靠机制。八条里有五条是算法自己越用越准的地方:误判会回流、词库会长、阈值会跟着品类走。
千川实判回来后逐句对账,分「同一处 / 同一类 / 没抓到」三类;没抓到的当场进词库,下一批就不再漏。这是模型自己纠正自己的入口。
拒审理由自动抠句入库,带上出处、命中的素材数和生效日期;新词条先进观察池,跑够样本再转正。
每一次改判都留版本:哪一句触发、哪个版本判的、改前改后差多少。结论永远能倒着查回原文。
口播转写、语境裁定、词库规则三条链路独立跑,差异超阈值自动标红。人只看分歧点,一致的批量过。
不同品类的通过率基线不同,分数按「该品类历史通过率 + 账号自身水平」校准,不拿一把尺子量所有素材。
模型的「我改好了」和独立复检分开记;两者不一致时以复检为准,自述不算证据。
少于 N 个班次 / N 条素材只标「样本少」,不给结论、不进结论页,避免小样本把参数带偏。
任务状态每日扫一遍,失败当天浮出不等下次;算人效时先扣掉大盘与同组中位数,不把大盘的账算到个人头上。
不是写在手册里让人照做,而是长在脚本与数据表里:漏了会报、偏了会标、样本不够不给结论。
/ 05 — Engine
不是把规则写死,是把判断交给模型 —— 素材进来那一刻才开始算。每条片子现场读口播、读画面、读同批数据,再决定它该走哪套判据。
不是等间隔抽帧。模型按口播停顿点与画面变化点决定看哪几帧 —— 一条 30 秒的片子通常只看 5–8 帧就能定性。
判据现场生成,不是查表。同一条文案换品类、换账号,模型给出的风险点会不一样 —— 这才是"同一句话,不同场合判得不同"。
按素材类型自己决定走几条链:纯口播走两层,带画面的走三层。跑多少、花多少钱,跑之前就说清楚。
判完立刻回写库与看板,下一次分析当场用上。人在看结果的时候,下一批已经在跑了。
本页为内部系统的能力概览,所有账号名、品牌名、素材与投放数值均已脱敏: 数据以打码或无刻度示意呈现,不代表任何真实投放结果。界面截图为示意稿, 与生产环境的布局一致,数值非真实。如需了解具体能力,欢迎直接沟通。